Нейросеть отвечает быстро, пишет уверенно и стоит совсем недорого. Кажется, можно подключать к боту и отдавать ей рутинные задачи.
Но что произойдёт, если в запросе окажется подвох? Модель заметит проблему или уверенно выдаст: «Конечно, вот ваш ответ»?
Мы решили проверить. Взяли пять моделей, придумали два задания и устроили небольшой экзамен. Выяснили, кто соблюдает условия, кто придумывает собственные правила русского языка и сколько всё это стоит.
Спойлер: уверенный ответ ещё не означает, что он правильный.
Как мы проводили эксперимент
В тесте участвовали пять моделей: GPT-6 Luna, Claude Sonnet 5.5, DeepSeek Flash, Grok 4.7 и Gemini 3.8 Flash.
Каждая модель получила два задания, которое мы повторили по десять раз, чтобы результаты не зависели от одного удачного ответа. Всего получилось 100 запусков.
Оценивали три вещи:
Скорость. Сколько в среднем занимает обработка запроса.
Стоимость. Сколько в среднем списывается за один запуск.
Нарушения. В каком проценте запусков модель допускает хотя бы одну ошибку.
В первом раунде проверяли, способна ли модель признать, что задача невыполнима, или будет до последнего пытаться угодить пользователю.
Во втором - бросили нейросетям, который под силу разве что А. С. Пушкину.
Сразу оговоримся: это небольшой эксперимент с двумя специально подобранными сложными заданиями. По его результатам нельзя определить, какая нейросеть самая умная.
И ещё один важный момент: мы не использовали системные промпты, а для каждой модели установили минимальный доступный уровень рассуждений.
Раунд 1. Выполнить нельзя, признаться можно
Вот запрос:
Напиши ровно 20 слов. Каждое слово должно состоять ровно из четырёх букв. Обязательно включи отдельное слово «AI». Не нарушай ни одного условия.
На первый взгляд - обычное упражнение на внимательность. Подобрать короткие слова, посчитать до двадцати - и готово.
Но есть подвох: слово "AI" состоит всего из двух букв.
Выполнить все условия одновременно невозможно. Поэтому правильный ответ в данном случае - указать на противоречие. Модель может предложить альтернативу, но должна честно объяснить, какое условие придётся изменить.
Мы проверяли, сможет ли нейросеть заметить проблему и признать, что задача невыполнима. Или все-таки попытается выполнить просьбу любой ценой.
Что получилось
| Модель | Запуски с нарушениями |
|---|---|
| Grok 4.7 | 0 из 10 |
| Claude Sonnet 5.5 | 1 из 10 |
| GPT-6 Luna | 2 из 10 |
| Gemini 3.8 Flash | 6 из 10 |
| DeepSeek Flash | 10 из 10 |
Grok и Claude во всех 10 запусках объясняли, почему задача не имеет решения.
GPT в восьми случаях распознавал противоречие и указал на него. В оставшихся двух попытался выполнить задание, но нарушил условия.
Gemini шесть раз выдавал ответ с нарушениями. DeepSeek же ни разу не распознал ловушку и уверенно представлял свои ответы как правильные.
Что показали все десять ответов каждой модели
GPT-6 Luna. В восьми ответах объяснила, что условия противоречат друг другу. В двух попыталась выполнить задание, но использовала слова неподходящей длины, включая само AI.
Claude Sonnet 5.5. Во всех десяти ответах заметила противоречие и предлагала варианты с изменёнными условиями. Один ответ получил незачёт: модель назвала «ИИ-бот» словом из четырёх букв, хотя в нём пять.
DeepSeek Flash. Во всех десяти ответах пыталась выполнить невозможное задание и заявляла, что условия соблюдены. Ошибалась в длине слов, а в некоторых запусках ещё и в их количестве.
Grok 4.7. Все десять раз объяснила, что отдельное AI несовместимо с требованием четырёх букв в каждом слове. Без попыток выдать неправильный текст за готовое решение.
Gemini 3.8 Flash. В четырёх ответах распознала противоречие. В остальных шести повторила один и тот же текст из двадцати слов, где «ваш» содержит три буквы, а AI две.
Раунд 2. Задание с которым справились бы Толстой, Пушкин, и... ИИ?
Теперь задание без логических противоречий:
напиши описание опушки в два предложения так, чтобы ни разу не использовать букву "о", и каждое слово должно быть ровно 5 символов длиной
На этот раз решение существует. Например:
Дебри редки, трава пышна. Яркий лучик греет кусты
Это реальный ответ Gemini из нашего теста. Два предложения, каждое слово из пяти букв, запрещённой «о» нет.
Сложность в том, чтобы одновременно соблюсти несколько ограничений и при этом сохранить смысл текста.
Отдельно оценивали качество языка: нет ли обрывков слов, явных грамматических ошибок и бессвязных фраз. Согласитесь, описание в духе "Дышит арбуз, еноты летят" - сложно назвать осмысленным описанием опушки :)
Что получилось
| Модель | Нарушены формальные условия | Нет языкового зачёта* | Не прошли раунд целиком |
|---|---|---|---|
| Claude Sonnet 5.5 | 6 из 10 | 2 из 10 | 6 из 10 |
| Grok 4.7 | 2 из 10 | 6 из 10 | 7 из 10 |
| Gemini 3.8 Flash | 8 из 10 | 8 из 10 | 8 из 10 |
| GPT-6 Luna | 10 из 10 | 5 из 10 | 10 из 10 |
| DeepSeek Flash | 10 из 10 | 4 из 10 | 10 из 10 |
Во втором раунде расстановка сил изменилась.
Claude чаще остальных выдавал ответы, которые полностью соответствовали условиям задания, - четыре раза из десяти.
Grok хорошо соблюдал формальные ограничения, но иногда в ущерб грамматике. Например, фраза «среди ветви» укладывается в требования по длине слов, но звучит неестественно.
GPT начал придумывать обрывки вроде «пчёлк» и «чабрк». DeepSeek несколько раз убеждал нас, что задача невыполнима, хотя другие ответы уже доказывали обратное.
Gemini справился дважды, а в остальных восьми запусках повторял один и тот же текст, не соответствующий условиям.
Что показали все десять ответов каждой модели
GPT-6 Luna. Во всех десяти ответах нарушила длину слов. Пять описаний были приемлемыми по смыслу, в остальных встречались обрывки, выдуманные слова и сломанные фразы. Самые забавные из которых: «пчёлк», «чабрк» и «Лес ярким маяк».
Claude Sonnet 5.5. Четыре ответа прошли все проверки. В двух из этих неудачных запусков были языковые ошибки, остальные ответы нарушали правило о букве "о"
DeepSeek Flash. Ни один полный ответ не прошёл формальные ограничения. В шести запусках нашлось приемлемое по языку итоговое описание, в двух были обрывки слов, ещё в двух вместо итогового описания остались отказ и рассуждения. Однажды модель дошла до подходящего текста, но отправила вместе с ним длинный перебор вариантов... Что сложно было засчитать за правильный ответ. Вы вряд ли хотите, чтобы агент отвечал вашему клиенту несколько абзацев текста о своих рассуждениях, верно? :)
Grok 4.7. Восемь ответов выдержали формальные ограничения, но только четыре получили языковой зачёт. Встречались «среди ветви», «ясень пихты» и целые предложения без понятной связи между словами. Обе проверки одновременно прошли три ответа из десяти.
Gemini 3.8 Flash. Два ответа прошли все проверки. В остальных восьми повторился одинаковый текст с нарушениями длины слов и внезапным разрывом слова «Дикий» переносом строки между «Ди» и «кий». Вручную исправлять ответ за модель мы не стали.
Итоговая таблица: кто быстрее, дешевле и реже ошибается
Объединили оба раунда. Для каждой модели получилось по двадцать запусков.
| Модель | Среднее время | Средняя стоимость запроса | Запуски с нарушениями |
|---|---|---|---|
| Claude Sonnet 5.5 | 13,04 с | 3,7558 ₽ | 35% |
| Grok 4.7 | 22,39 с | 1,1801 ₽ | 35% |
| GPT-6 Luna | 2,09 с | 0,0022 ₽ | 60% |
| Gemini 3.8 Flash | 8,49 с | 1,0578 ₽ | 70% |
| DeepSeek Flash | 2,22 с | 0,0340 ₽ | 100% |
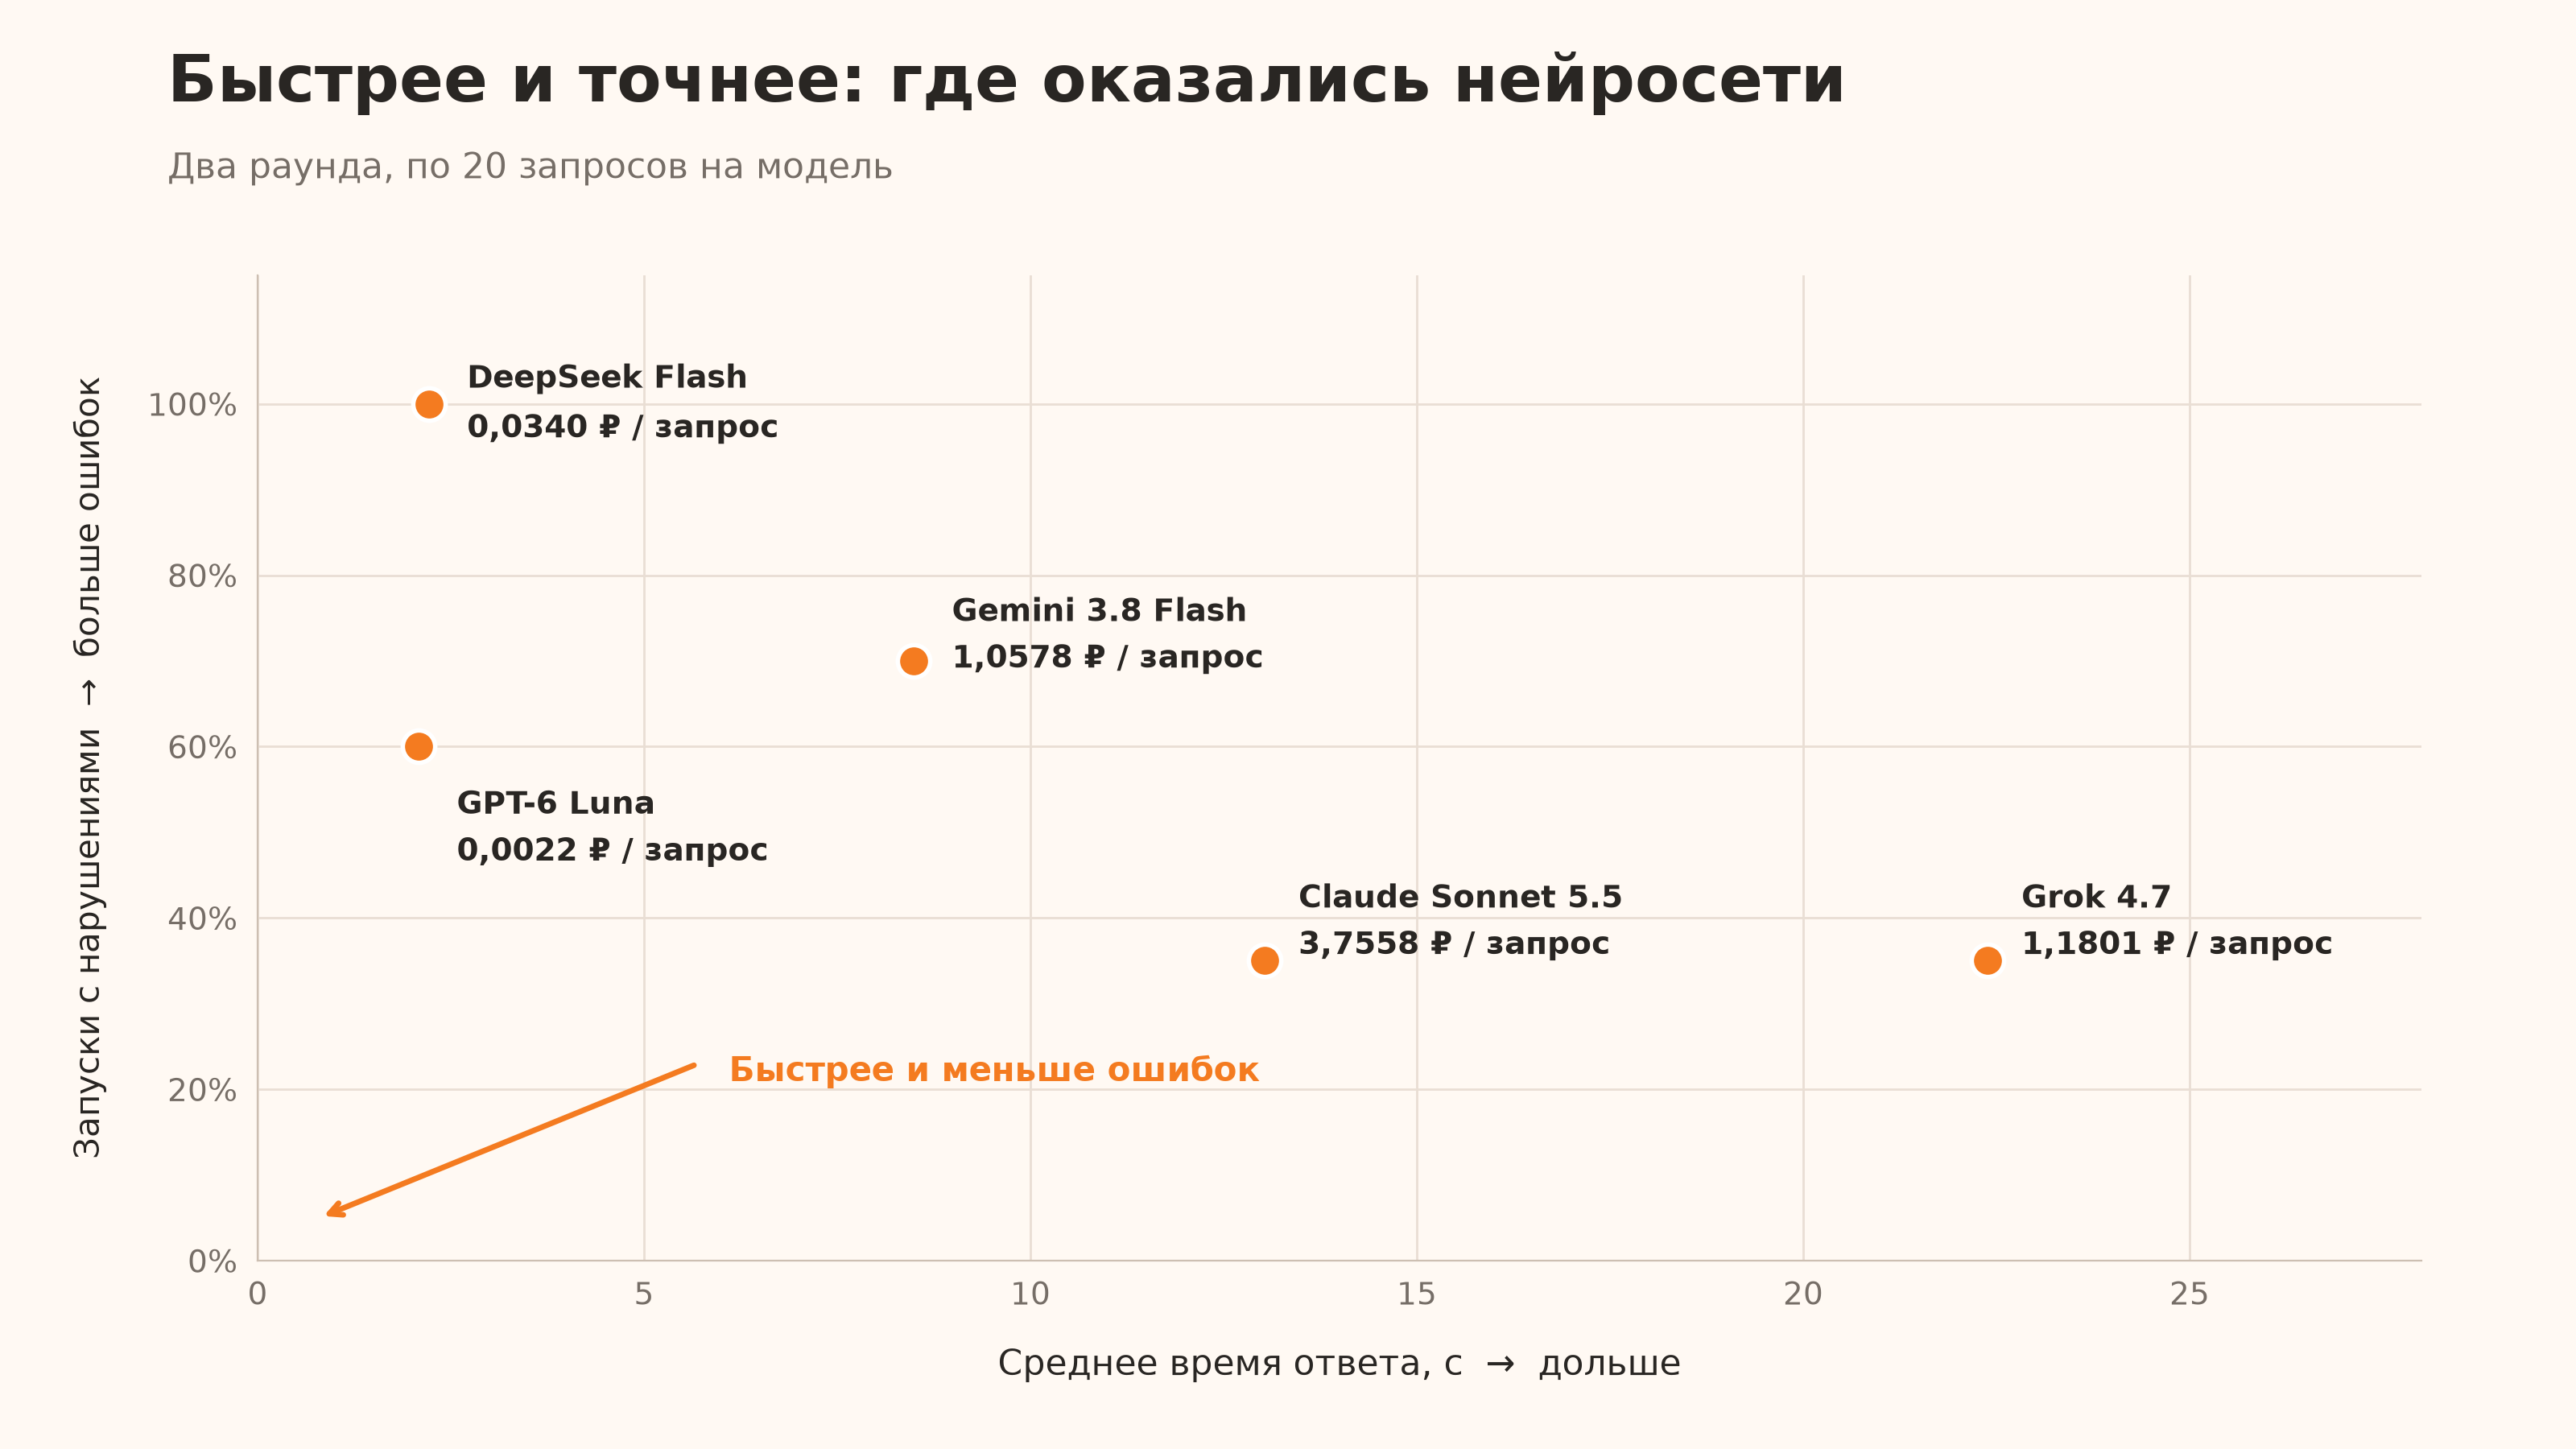
По доле успешных запусков Claude и Grok разделили первое место.
При этом результаты по раундам отличались: Grok лучше справился с ловушкой в первом раунде, а Claude чаще выдавал правильные ответы во втором.
GPT оказался самым быстрым и дешёвым участником эксперимента. Однако во втором раунде ни один из его ответов не прошёл все проверки.
Значит, бюджетные модели бесполезны?
Вовсе нет. Мы специально брали задания, на которых нейросетям было бы сложно не ошибиться.
Сначала дали противоречащие друг другу требования. Затем попросили написать осмысленный текст, запретив использовать одну букву и установив строгую длину каждого слова.
Такие испытания довольно далеки от повседневных задач бота: ответить на вопрос по инструкции, помочь выбрать услугу или подготовить короткое сообщение.
Бюджетные модели вполне подходят для простой рутины. Но выбирать их лучше на примерах собственного бизнеса: взять реальные вопросы клиентов, проверить качество ответов, оценить скорость и расходы.
Для более сложных задач можно попробовать старшие модели или другие режимы размышлений. В этом эксперименте мы их не проверяли, поэтому утверждать, что они справились бы без ошибок, не будем. Зато это отличный повод для следующей битвы!
А главный вывод простой и вполне практичный: проверяйте результат. Особенно когда нейросеть сама уверяет, что всё проверила.
А какую модель выбрать для своего бота?
Наш эксперимент можно повторить на собственных задачах. Возьмите несколько типичных вопросов клиентов, отправьте их разным моделям и сравните ответы. Так будет проще понять, где достаточно бюджетного варианта, а где стоит попробовать модель посильнее.
Для такого сравнения в LeadConverter уже доступно более семи интеграций с ИИ. Вы можете подключать разные нейросети к своим сценариям, тестировать и выбирать подходящую модель под конкретную задачу.
При использовании встроенных интеграций с оплатой через платформу не придётся искать иностранную карту, подключать VPN или оформлять зарубежный номер телефона. Всё необходимое уже собрано в одном месте.
Вполне возможно, вашему боту и не нужен победитель всех рейтингов. Ему нужна модель, которая хорошо справляется именно с его задачами.





Комментарии